Nếu bạn đang dùng Antigravity để phát triển phần mềm và có cảm giác rằng AI lúc thì làm việc cực kỳ thông minh, lúc lại sửa một lỗi đơn giản thành một mớ hỗn độn, rất có thể vấn đề không nằm ở Antigravity. Vấn đề nằm ở cách bạn chọn model để giao việc.
Đây là một sai lầm khá phổ biến khi bắt đầu làm việc với các coding agent. Chúng ta thường có xu hướng nghĩ rằng: model nào mạnh nhất thì cứ giao tất cả cho model đó. Nhưng trong thực tế, cách làm này vừa tốn tài nguyên, vừa không tối ưu tốc độ, thậm chí đôi khi còn cho kết quả kém hơn việc phân chia công việc cho nhiều model khác nhau.
Khi làm việc với Antigravity, điều quan trọng không phải là tìm ra một model "vô địch", mà là xây dựng được một quy trình trong đó mỗi model đảm nhận đúng loại công việc mà nó có thế mạnh.
Antigravity mạnh đến đâu còn phụ thuộc vào model bạn giao việc
Antigravity có thể trở thành một môi trường phát triển cực kỳ mạnh khi kết hợp đúng model. Nhưng bản thân agent không phải là tất cả. Chất lượng kết quả phụ thuộc rất nhiều vào khả năng reasoning, context, tốc độ phản hồi và cách model xử lý repository của bạn.
Một dự án thực tế thường không chỉ có một loại công việc. Có lúc bạn cần đọc hàng trăm file để hiểu kiến trúc. Có lúc chỉ cần tìm một function. Có lúc cần sửa một bug nhỏ. Nhưng cũng có lúc bạn cần audit toàn bộ hệ thống để tìm lỗi phân quyền hoặc những lỗ hổng bảo mật nằm sâu trong business logic.
Nếu sử dụng cùng một model cho tất cả những việc này thì chẳng khác nào thuê một kiến trúc sư cao cấp chỉ để tìm một dòng code, hoặc ngược lại, giao một task security audit nghiêm trọng cho một model chỉ phù hợp với những thay đổi nhỏ.
Vì vậy, cách tiếp cận hiệu quả hơn là phân tầng model theo độ phức tạp của công việc.
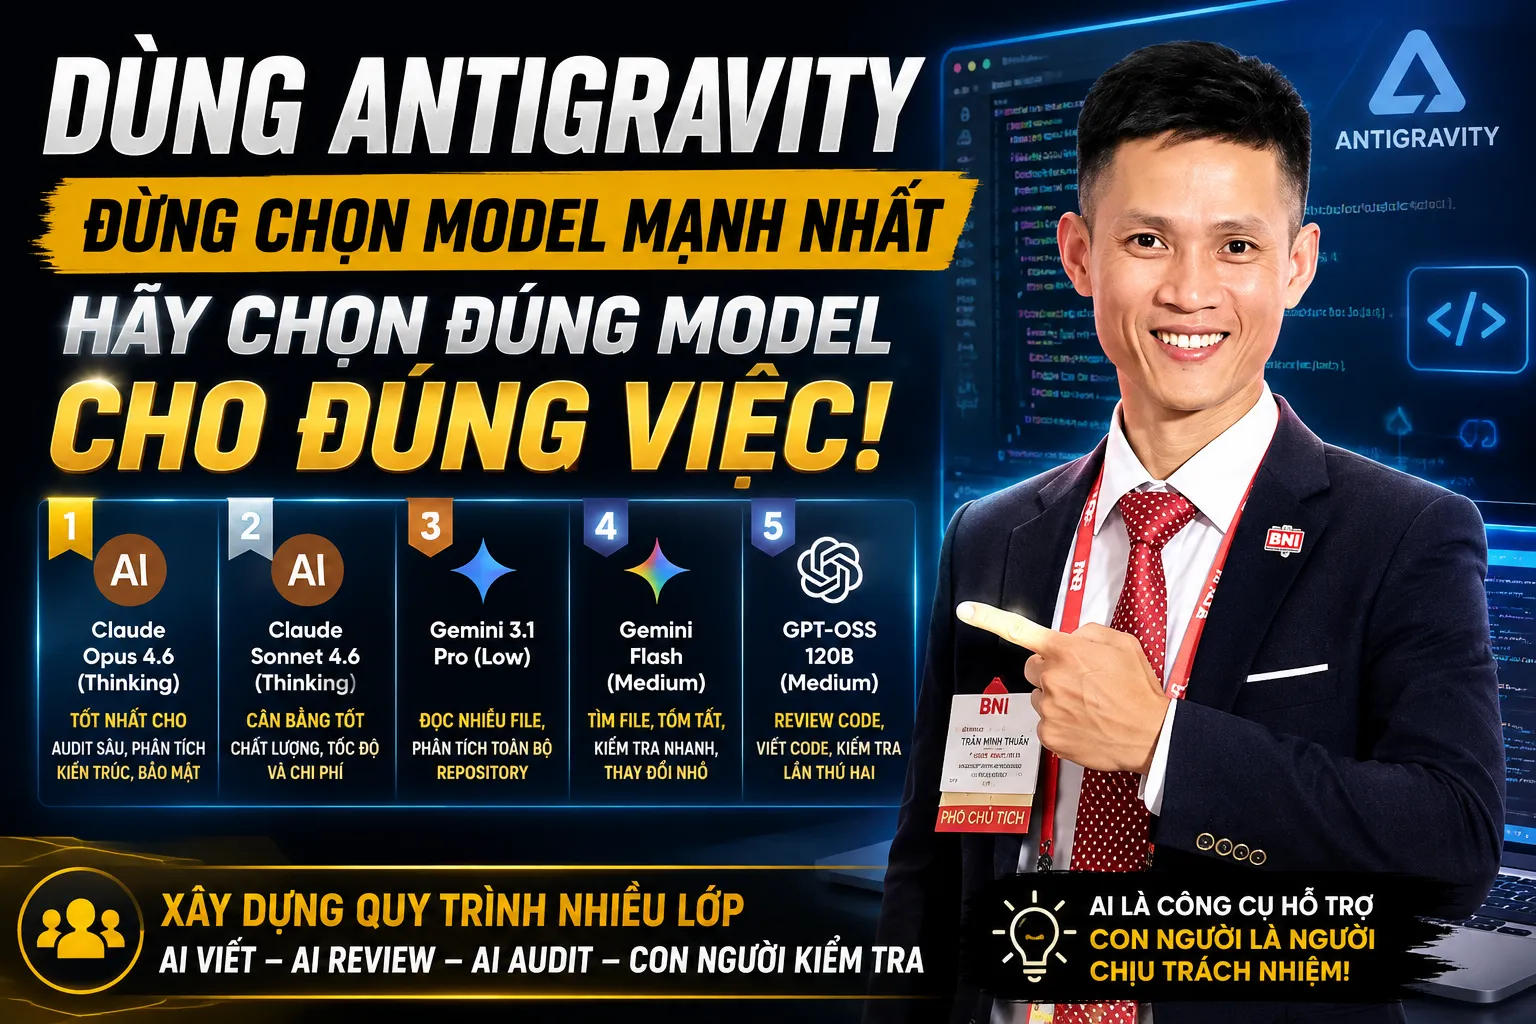
Claude Opus 4.6 Thinking: Khi hệ thống cần được "mổ xẻ" thật sâu
Trong những công việc yêu cầu phân tích sâu, Claude Opus 4.6 với Thinking là một lựa chọn rất đáng ưu tiên.
Đặc biệt khi bạn đang xử lý một hệ thống có nhiều module, nhiều tầng permission, nhiều API hoặc business logic phức tạp, vấn đề không còn nằm ở việc "code có chạy hay không". Câu hỏi quan trọng hơn là: code có thể bị khai thác theo cách nào mà người viết chưa nghĩ tới?
Đây là lúc Opus phát huy giá trị.
Bạn có thể giao cho model những nhiệm vụ như audit kiến trúc, phân tích luồng authentication và authorization, kiểm tra phân quyền giữa các role, tìm privilege escalation, phân tích những luồng dữ liệu nhạy cảm hoặc tìm những lỗi logic có thể xảy ra khi nhiều module tương tác với nhau.
Điểm quan trọng là đừng chỉ yêu cầu AI "kiểm tra xem code có lỗi không". Một yêu cầu tốt hơn sẽ buộc model suy nghĩ như một người kiểm thử hoặc attacker: nếu tôi là người dùng không có quyền, tôi có thể làm gì? Nếu tôi thay đổi ID trong request thì chuyện gì xảy ra? Nếu API được gọi trực tiếp thay vì thông qua giao diện thì permission có còn được kiểm tra không? Nếu một user thay đổi role hoặc tham số request thì hệ thống phản ứng thế nào?
Đó là những câu hỏi giúp security audit đi xa hơn một vòng code review thông thường.
Vì vậy, nếu phải xử lý một vấn đề thực sự quan trọng, phức tạp hoặc có khả năng ảnh hưởng toàn hệ thống, Opus Thinking nên nằm trong nhóm model đầu tiên bạn cân nhắc.
Claude Sonnet 4.6 Thinking: Model "ngựa chiến" cho công việc hàng ngày
Nếu Opus phù hợp với những trận đánh lớn thì Sonnet 4.6 Thinking lại giống như người bạn đồng hành trong công việc hàng ngày.
Đây là model mình đánh giá phù hợp để sử dụng thường xuyên vì nó tạo được sự cân bằng khá tốt giữa chất lượng, tốc độ và chi phí.
Phần lớn công việc phát triển phần mềm thực tế không phải là những bài toán security audit cấp độ cao. Chúng ta thường xuyên phải sửa bug, refactor một đoạn code, xây dựng một API, thêm một chức năng, sửa giao diện, phân tích một function hoặc cải thiện một module đang tồn tại.
Với những công việc như vậy, Sonnet Thinking là lựa chọn rất hợp lý.
Một điểm quan trọng trong quá trình làm việc với AI là bạn không nên mặc định rằng "model mạnh nhất = model tốt nhất". Nếu một task chỉ yêu cầu sửa một function thì việc sử dụng model reasoning cực sâu có thể không mang lại lợi ích tương xứng với thời gian và tài nguyên bỏ ra.
Do đó, nếu bạn đang xây dựng một workflow lâu dài với Antigravity, Sonnet Thinking có thể xem là model sử dụng thường xuyên, còn Opus được dành cho những vấn đề cần phân tích sâu hơn.
Gemini 3.1 Pro: Lợi thế khi phải đọc một repository lớn
Một công việc mà coding agent thường xuyên phải thực hiện là đọc và hiểu codebase.
Đây cũng là lúc Gemini 3.1 Pro trở nên đáng chú ý.
Với những dự án có rất nhiều file, nhiều module và lượng context lớn, khả năng đọc và phân tích một repository rộng có thể mang lại lợi thế đáng kể. Thay vì chỉ nhìn vào một file rồi suy đoán, model có thể giúp bạn xây dựng bức tranh tổng thể về dự án: module nào chịu trách nhiệm cho chức năng nào, các thành phần liên kết với nhau ra sao, dữ liệu đi qua những tầng nào và những file nào có khả năng liên quan đến vấn đề đang cần xử lý.
Tuy nhiên, có một điểm cần lưu ý: nếu đang sử dụng reasoning ở mức Low thì tôi sẽ không mặc định giao cho model này những nhiệm vụ security audit nghiêm trọng nhất.
Đọc được nhiều code không đồng nghĩa với việc phân tích security sâu trong mọi tình huống. Hai năng lực này có liên quan nhưng không hoàn toàn giống nhau.
Nếu hệ thống cung cấp mức reasoning cao hơn, những task phức tạp nên cân nhắc tăng reasoning để model có thêm "độ sâu" khi phân tích.
Gemini Flash: Đừng dùng đại bác để xử lý những việc nhỏ
Trong một workflow thực tế, bạn sẽ có hàng chục, thậm chí hàng trăm tác vụ nhỏ.
Ví dụ như tìm file xử lý login, xác định function nào đang kiểm tra token, tìm nơi khai báo một class, đọc nhanh một module, tóm tắt chức năng của một file hoặc thực hiện một thay đổi nhỏ đã được xác định rất rõ.
Đối với những nhiệm vụ này, các phiên bản Gemini Flash ở mức Medium có thể rất phù hợp.
Ưu điểm lớn nhất của nhóm model này là tốc độ. Bạn không cần một quá trình reasoning quá sâu để trả lời câu hỏi "function này nằm ở đâu?" hoặc "file nào đang xử lý API này?".
Hãy tưởng tượng bạn có một đội ngũ kỹ thuật. Bạn sẽ không gọi kiến trúc sư trưởng vào mỗi lần cần tìm một chiếc bug nhỏ trong giao diện. Tương tự, không nhất thiết phải sử dụng model reasoning mạnh nhất cho mọi yêu cầu.
Task nhỏ, phạm vi rõ ràng, cần tốc độ → Flash là lựa chọn hợp lý.
Tuy nhiên, có một ranh giới cần nhớ: không nên sử dụng Flash như model duy nhất cho những security audit nghiêm trọng. Một model nhanh và tiện lợi cho công việc hàng ngày không đồng nghĩa với việc nó là lựa chọn phù hợp để đưa ra kết luận cuối cùng về một lỗi bảo mật Critical.
GPT-OSS 120B: Một góc nhìn thứ hai có thể rất giá trị
GPT-OSS 120B cũng có thể được sử dụng cho việc review và viết code. Tuy nhiên, chất lượng thực tế còn phụ thuộc vào hạ tầng và provider mà bạn đang sử dụng.
Vì vậy, thay vì xem nó như một model mà bạn phải mặc định tin tưởng, tôi thấy nó phù hợp hơn trong vai trò second opinion.
Đây là một tư duy rất quan trọng khi sử dụng AI trong phát triển phần mềm.
Giả sử Claude phát hiện một vấn đề trong hệ thống. Bạn có thể đưa vấn đề đó cho một model khác và yêu cầu kiểm tra độc lập. Nếu cả hai cùng phát hiện một vấn đề giống nhau, mức độ đáng quan tâm sẽ tăng lên.
Ngược lại, nếu hai model đưa ra hai kết luận khác nhau thì đó chính là lúc con người cần kiểm tra lại.
Đặc biệt đối với các lỗi bảo mật Critical, tuyệt đối không nên có tư duy "AI nói không có lỗi thì coi như không có lỗi".
AI là công cụ hỗ trợ phân tích. Nó không phải người chịu trách nhiệm cuối cùng cho hệ thống của bạn.
Workflow tôi khuyến nghị khi làm việc với Antigravity
Thay vì chọn một model rồi giao tất cả công việc, bạn có thể xây dựng một workflow nhiều lớp.
Đầu tiên, có thể sử dụng Gemini 3.1 Pro để đọc repository và giúp bạn hiểu cấu trúc tổng thể của dự án. Mục tiêu ở giai đoạn này không nhất thiết là sửa code mà là xây dựng context: hệ thống có những module nào, những file quan trọng nằm ở đâu và các luồng chính hoạt động như thế nào.
Sau đó, Sonnet Thinking có thể đảm nhận phần lớn công việc phát triển hàng ngày. Đây là lúc bạn giao các task như xây dựng feature, sửa bug, refactor, viết API hoặc thay đổi logic.
Sau khi hoàn thành một tính năng quan trọng, đừng vội deploy.
Hãy đưa phần code vừa thay đổi cho Opus Thinking và yêu cầu thực hiện một vòng audit độc lập. Quan trọng nhất là yêu cầu model tìm những vấn đề mà developer có thể đã bỏ sót, đặc biệt tập trung vào authentication, authorization, permission, validation, data leakage, business logic và các tình huống edge case.
Sau đó, nếu đây là một thay đổi đặc biệt quan trọng, bạn có thể sử dụng một model khác như GPT-OSS 120B để thực hiện thêm một vòng review.
Cuối cùng, con người vẫn là người quyết định.
Đây chính là điểm khác biệt giữa việc "dùng AI để code" và xây dựng một quy trình phát triển phần mềm có AI hỗ trợ.
Sai lầm lớn nhất: Để một model tự viết rồi tự kết luận rằng nó đúng
Đây có lẽ là điều tôi muốn nhấn mạnh nhất.
AI viết code rất nhanh. Nhưng tốc độ viết code không đồng nghĩa với tốc độ tạo ra phần mềm tốt.
Một model có thể viết một tính năng trong vài phút nhưng vẫn bỏ sót một lỗi permission nghiêm trọng. Nó có thể sửa được bug trước mắt nhưng vô tình tạo ra một regression ở một module khác. Nó cũng có thể đánh giá code của chính nó là an toàn bởi vì nó đang nhìn vấn đề từ chính góc độ mà nó vừa sử dụng để xây dựng giải pháp.
Vì vậy, đừng xây dựng quy trình:
AI viết → AI nói OK → Deploy.
Hãy xây dựng:
AI phân tích → AI viết → AI review → AI audit độc lập → Test → Con người kiểm tra → Deploy.
Đặc biệt với các hệ thống có dữ liệu khách hàng, thanh toán, tài khoản người dùng hoặc phân quyền nhiều cấp, việc có thêm một vòng kiểm tra độc lập là cực kỳ đáng giá.
Cuối cùng, vấn đề không phải là "model nào mạnh nhất?"
Sau khi sử dụng nhiều model trong cùng một môi trường, tôi nghĩ câu hỏi đáng đặt ra không phải là:
"Claude hay Gemini hay GPT mạnh hơn?"
Câu hỏi đúng hơn là:
"Công việc này cần loại năng lực nào?"
Nếu cần audit sâu và phân tích kiến trúc phức tạp, hãy nghĩ đến Opus Thinking.
Nếu cần một model cân bằng để làm việc hàng ngày, Sonnet Thinking là lựa chọn rất đáng cân nhắc.
Nếu cần đọc một repository lớn và xử lý nhiều context, Gemini Pro có lợi thế riêng.
Nếu cần tìm file, tóm tắt, kiểm tra nhanh hoặc sửa những thay đổi nhỏ, Flash có thể giúp bạn tiết kiệm rất nhiều thời gian.
Nếu cần thêm một góc nhìn độc lập, GPT-OSS 120B có thể đóng vai trò reviewer thứ hai.
AI càng mạnh, cách sử dụng càng phải có chiến lược.
Antigravity không chỉ giúp chúng ta viết code nhanh hơn. Nếu biết phân công đúng model, chúng ta có thể biến nó thành một quy trình làm việc gần giống một đội ngũ kỹ thuật: có người đọc hệ thống, có người phát triển, có người review và có người chuyên tìm những thứ mà người khác bỏ sót.
Và đó mới là cách khai thác sức mạnh thực sự của AI trong phát triển phần mềm.
Đừng tìm một model làm được tất cả. Hãy xây dựng một quy trình trong đó mỗi model làm đúng việc mà nó giỏi nhất.